行长智能体
让每一个想法,成为好作品。
从文案、图片、视频到数字人,一站式 AI 创作工作台。
从视频中,发现好文案
粘贴分享链接,下载视频后提取口播文案。
热门功能推荐
我的创作数据
完整创作工具箱
按创作目标选择,常用工具一步直达
最近使用
找到你的创作工具
从一个想法出发,选择下一步。
本页展示网页版已开放的工具。电脑本地剪辑、发布与外部连接请使用桌面版。
我的创作空间
账号、服务与使用偏好,都在这里。
创作服务
手机网页版使用说明
图片、视频、数字人与配音使用现有云端服务,账号权益和任务状态以后台为准。
视频文案提取支持选择本机视频、音频,或允许跨域访问的 HTTPS 媒体直链。平台分享页面请先保存视频再上传。个人文字与语音 API 需在对应工具内配置。
素材库和未提交草稿保存在当前设备与浏览器,不会自动同步到电脑。重要结果请及时下载备份。
电脑本地剪辑与发布功能请使用桌面版。微信内文件选择或下载受限时,可通过右上角菜单在系统浏览器中打开。
模块
行长智能体能干嘛?怎么用?
一句话:这是一套 AI 电商内容创作工作台,把「文案、图片、声音、数字人视频」一站式做出来。上传素材、点生成、下载成片,不用会剪辑、不用会配音、不用请模特。
不会拍、不会出镜,也能做口播带货视频。
- 一键数字人:文案 + 一张照片 → 自动配音 + 口播视频
- 走路口播:门店/街景 + 人物 → 边走边喊带货
- 数字人带货:产品图 + 人物 → 手持产品口播卖货
- 最强数字人 / 主播同款:更真实的表情、口型、手势
不想用真人声音、憋不出文案,交给 AI。
- 声音克隆:1 分钟复刻你的音色,以后都用它配音
- 音色迁移:保留原话的语气节奏,换成目标音色
- 详情页设计:产品图 → 卖点文案 + 直播脚本
- 视频文案提取:抄爆款口播,拆出文案参考
商品图、封面、去字、放大,一张图全搞定。
- 文生图 / 图生图:一句话生成电商主图
- 封面设计:一键生成促销感爆棚的封面
- 洗图防查重:像原图又不一样,安全发布
- 高清放大 / 换人 / 去字
换人、首尾帧、对口型、跳舞、剪辑,一步到位。
- 视频换人:把视频里的人换成指定人物
- 首尾帧视频:首图 + 尾图 → 平滑过渡成片
- 全能参考:参考图 + 提示词 → 融合生成新视频
- 对口型 / 动作迁移 / 模仿跳舞
- 最强自动剪辑:一句话「去停顿、加字幕」自动剪
抖音/快手带货短视频 · 口播视频 · 商品主图 · 详情页文案 · 直播脚本 · 门店引流 · 数字人直播带货。选一个上面的快捷入口,点进去就能看到具体教程和案例。
最强自动剪辑 Agent
对话剪辑 · 进度自动保存 · 继续原工程
快捷指令
人物形象 人物库:保存你的专属形象,一键传送到数字人
上传并保存你的人物形象(正面 / 全身照),点「使用」即可一键传送到任意数字人功能。
点击或拖拽人物图片到这里,自动保存到人物库
支持 jpg / png / webp素材会复制到软件的 uploads/library 目录,显示保存成功后可删除桌面原文件。请勿删除软件自己的素材目录。
声音资产 音色库:保存你的声音与情感参考,一键传送到数字人 / 声音克隆
上传并保存你的声音(音色样本),点「使用」即可传送到任意数字人功能当语音。
音色和情感参考会复制到软件的 uploads/library 目录,显示保存成功后可删除桌面原文件。
点击或拖拽音频到这里,自动保存到音色库
建议 10 秒 ~ 5 分钟,人声清晰成片素材 成片素材库:把视频/图片分组建好,做片时一键套用
先按用途建几个组,比如「美食带货」「工厂视频」,再把素材放进去。之后在「一键成片」里选一个组就能直接出片,不用每次重新上传。
点击或拖拽视频/图片到这里,自动保存进上面选中的组
支持 mp4 / mov / jpg / png 等,每个素材不超过 800MB素材会复制到软件内,删除桌面原文件不影响使用。当前显示:全部素材
配乐资产 BGM 库:保存你的背景音乐,一键成片直接选用
把常用的背景音乐上传到这里,之后在「一键成片 → 背景音乐 → 从 BGM 库选择」里直接点选,不用每次重新上传。
点击或拖拽音乐到这里,自动保存到 BGM 库
支持 mp3 / m4a / wav / flac / ogg,单首不超过 60MB音乐保存在软件内,删除桌面原文件不影响使用。
AI 配音 声音克隆:一分钟拥有你的专属音色,说任何话
点击选择或拖拽音频到这里
上传后立即用于克隆该音色点击选择或拖拽音频到这里
不传则只用音色样本自带语气预计 40~60 秒
AI 配音 全能方言版声音克隆:自动识别 600 多种方言
点击选择或拖拽音频到这里
上传要模仿的声音,克隆后用任意方言说台词预计 60~120 秒
明星音色 音色迁移:同一段台词,换成"大咖音"重新演绎
点击选择或拖拽音频到这里
这段音频的"话/歌"会保留,只换声音点击选择或拖拽音频到这里
用这个声音去唱/念原音频大白话:一段音频的"说话内容/唱歌节奏"不变,把声音换成另一个人的音色。适合把别人的爆款音频换成自己的声音、翻唱、配音等。
一键换人 图生图:指定人物替换 + 自动去文字,干净成片
点击选择或拖拽素材图到这里
自动读取尺寸点击选择或拖拽人物图到这里
上传后即指定「替换成这个人」预计 1~2 分钟
提示:在「输出比例」选择画幅即可(默认 9:16 竖屏);两张图都上传才能「替换人物」,只传一张则做去文字 / 局部重绘。
批量任务共用上方「输出比例 / 分辨率 / 格式」,每个任务独立上传素材图 + 人物图 + 提示词。
换人 图生图换人:上传两张人物图,一键生成换人图
点击选择或拖拽图片到这里
人物 A点击选择或拖拽图片到这里
人物 B预计 1~3 分钟
提示:需上传两张图片才能生成。默认 4:3 比例、2K 分辨率。
爆款生成 文生视频:一句话,AI 帮你生成大片级短视频
1~15 秒,超过 15 自动按 15
预计 2~5 分钟
本功能按当前选择的积分或钱包模式结算;结果链接有时效,请及时下载保存。
使用教程(点击展开)
- 填提示词:用一句话写清「画面主体 + 动作/运镜 + 风格 + 光线」。越具体效果越好,例如「一只戴红色围巾的柴犬站在雪地里回头笑,镜头慢慢拉近,雪花飘落,治愈系电影感」。
- 选画幅:发抖音/小红书选 9:16 竖屏,B站/西瓜选 16:9 横屏;选完会自动设置宽高,也可手动改。
- 选时长:1~15 秒自定义填写,超过 15 秒会自动按 15 秒;越短越快越省。
- 点生成:等待 2~5 分钟,页面会自动刷新进度。
- 下载:出片后点「⬇️ 下载」保存到本地。平台链接仅 24 小时内有效,请及时转存。
提示词建议写成「主体 + 动作 + 运镜 + 风格 + 光线 + 画质」六要素;中文英文都可以,英文效果通常更稳。
⚠️ 批量同样消耗平台币子,请确保账户余额/积分充足;结果 24 小时内有效请及时保存。
王炸功能 秒出视频(文生版):一句话,快速出片
预计 1~3 分钟
⚠️ 本功能消耗平台币子;结果链接 24 小时内有效,请及时下载保存。
王炸功能 秒出视频(首尾帧版):首帧 + 尾帧 + 提示词,快速出片
点击选择或拖拽首帧图片到这里
主体清晰、构图稳定,效果最好点击选择或拖拽尾帧图片到这里
建议与首帧主题一致,AI 会平滑过渡预计 1~3 分钟
⚠️ 本功能消耗平台币子;结果链接 24 小时内有效,请及时下载保存。
把图变视频 图生视频:一张图,让它动起来变成"会喊话"的短片
点击选择或拖拽图片到这里
画面清晰、主体明确,效果最好1~15 秒,超过 15 自动按 15
预计 2~5 分钟
⚠️ 本功能消耗平台币子,建议用「备用账户(消费)」扣币;结果链接 24 小时内有效,请及时下载保存。
使用教程(点击展开)
- 上传首帧图:选一张主体清晰、光线正常的图片(人物、产品、风景都行),越清晰效果越好。
- 写动作提示词:告诉 AI 画面里要发生什么,例如「人物转头微笑,头发飘动,镜头缓慢推进」。不要只写静止描述。
- 选时长和比例:1~15 秒自定义填写,超过 15 秒自动按 15 秒;比例默认「3(官方示例,跟随原图)」即可,如需强制横/竖屏可切换。
- 点生成:等待 2~5 分钟,页面自动刷新进度。
- 下载:出片后点「⬇️ 下载」保存。平台链接仅 24 小时内有效,请及时转存。
想让主体保持原样:提示词里写「人物面部特征/服饰保持与首帧一致,不变形」;想要运镜:写「镜头推进/环绕/平移」等。
⚠️ 批量同样消耗平台币子,请确保账户余额/积分充足;结果 24 小时内有效请及时保存。
爆款生成 首尾帧视频:首帧图 + 尾帧图 + 提示词,AI 自动补全中间运镜
点击选择或拖拽首帧图片到这里
主体清晰、构图稳定,效果最好点击选择或拖拽尾帧图片到这里
建议与首帧主题一致,AI 会平滑过渡1~30 秒,官方推荐 10 秒
预计 2~6 分钟
⚠️ 本功能消耗平台币子,建议用「备用账户(消费)」扣币;结果链接 24 小时内有效,请及时下载保存。
 首帧图
 尾帧图
查看案例提示词
加载中…
一键换人 视频换人 / 人物替换:上传视频和目标人物,AI 自动替换画面中的人物
视频换人:上传人物视频和角色图,替换画面中的人物。
点击选择或拖拽人物视频到这里
人物清晰、画面稳定,替换效果更好点击选择或拖拽模特图片到这里
正面清晰、五官完整,人物替换效果更稳定默认 30 帧
1~10 秒
点击选择或拖拽角色1图片到这里
正面清晰、五官完整,效果最好点击选择或拖拽角色2图片到这里
双人模式才需要上传1~35 秒,最长 35 秒
预计 2~6 分钟
⚠️ 本功能消耗平台币子,建议用「备用账户(消费)」扣币;结果链接 24 小时内有效,请及时下载保存。
独立效果案例,仅供参考;不是你的输入视频,也不会自动参与生成。
口播神器 数字人快速版:人物图 + 语音,秒出说话视频
点击选择或拖拽人物图到这里
上传后该人物会开口说话点击选择或拖拽音频到这里
可用「声音克隆」生成的语音,也可直接传任意音频0 = 整段音频;35 秒内效果更佳
从音频第几秒开始对口型
小于 1600,越大越慢
选非「跟随原图」时自动补模糊背景,人物不裁切
预计约 5 分钟
提示:本生成方案平均运行约 5 分钟,请耐心等待;结果视频 24 小时内有效,请及时下载。
最强数字人 · 升级版 数字人:人物图 + 音频,打造"会说话"的虚拟代言人
人物照片 + 语音 / 歌曲;支持完整音频、小数秒分段和帧率设置。
功能展示 · 最强数字人案例
以下是原版数字人的历史展示案例;本次生成使用升级接口,实际效果以本次输出为准。
查看原有图转视频示例
 人物图
使用教程(点开查看 + 参数说明)
第一步 · 准备素材:
- 人物图:正脸清晰、光线均匀,建议 9:16 或 16:9;半身或近景效果最好
- 音频:说话或唱歌均可(可用「声音克隆」生成的语音),先用 20~30 秒验证效果;长音频可按完整句子分段
- 动作提示词:用中文描述角色怎么说话/动作,下方有「可遵循的提示词模板」可直接套用
第二步 · 参数调整:
- 生成秒数:0 = 从起始位置处理完整剩余音频;填具体秒数生成指定片段,可填 12.5 等小数
- 音频起始秒:从音频第几秒开始对口型,可填小数(跳过开头空白/前奏)
- 分辨率最长边:默认 1280;必须小于 1920,保留人物图比例;分辨率越高通常越耗时
- 实例类型:默认 ultra(84G);也可选择 plus(48G) 或 default(24G),实际耗时与费用以任务为准
第三步 · 消耗说明:
本功能按平台 运行时长扣余额/积分(时长、分辨率与显存档位都会影响用量)。任务完成后可在「生成记录」里看到费用,余额会实时刷新。
点击选择或拖拽人物图到这里
上传后该人物会开口说话/唱歌点击选择或拖拽音频到这里
可用「声音克隆」生成的语音,也可直接传任意音频默认 0 = 完整音频。建议先用 20~30 秒试跑;长音频可按起始位置分段,实际完成时长受平台运行限制影响。
从音频第几秒开始对口型
选非「跟随原图」自动补模糊背景,人物不裁切
越大越清晰也越慢越耗余额
默认 24 帧/秒;越高通常越耗时
按素材和任务状态显示进度;长音频耗时与消耗会增加,结果链接 24 小时内有效请及时保存
越大越清晰也越慢越耗余额
默认 24 帧/秒;越高通常越耗时
门店引流 走路口播数字人:让虚拟人替你"边走边喊"带货
使用教程(点开查看)
三步出片:
- 背景图:上传门店门口 / 街景照片,人物会在这个场景里边走边口播
- 人物图:上传人物三视图(正面/侧面/背面)或全身照,效果更真实
- 语音:上传口播音频(可用「声音克隆」生成的语音),直接生成爆款口播视频
提示词修改:下方有「可遵循的提示词模板」(爆款口播/自然行走/边走边推销/探店推荐),也可自己改,控制人物动作、语气、镜头。
消耗说明:按平台运行时长扣余额/积分;宽高越大、用 48G 实例消耗越多。结果 24 小时内有效,请及时下载。
点击选择或拖拽背景图到这里
人物会在这个场景里边走边口播点击选择或拖拽人物图到这里
三视图或全身照效果更真实点击选择或拖拽音频到这里
可用「声音克隆」生成的语音0 = 整段音频;填 N 秒只生成前 N 秒口播
视频宽度 px,默认 576
视频高度 px,默认 1024
预计约 5~10 分钟 · 消耗余额/积分,结果 24 小时内有效请及时保存
带货口播 数字人带货:虚拟人手持产品,替你口播卖货
 参考背景图
 参考产品图
 参考人物图
查看案例提示词
角色面向镜头自然带货,口型与声音同步,表情自然,手持产品自然展示,突出产品卖点,手部动作自然流畅,固定机位,实拍写实质感。
使用教程(点开查看)
四步出片:
- 背景图:上传门店/直播间/街景背景
- 产品图:上传要带货的商品图
- 人物图:上传人物全身照或三视图,效果更真实
- 口播文案:在下方提示词里写清楚要说的台词、人物动作和镜头要求
提示词:控制人物动作、语气、镜头,可点下方「一键填入案例提示词」参考案例写法。
消耗说明:按平台运行时长扣余额/积分;宽高越大、用 48G/84G 实例消耗越多。结果 24 小时内有效,请及时下载。
点击选择或拖拽背景图到这里
人物会在这个场景里带货点击选择或拖拽产品图到这里
人物会手持这款产品口播点击选择或拖拽人物图到这里
三视图或全身照效果更真实此功能不支持上传音频。请把要说的台词直接写在下方;需要使用自己的录音时,请选择“主播同款数字人”或“最强数字人”。
建议先生成 5~10 秒;填写本次希望生成的秒数
宽度用于计算画面比例,默认 576
高度用于计算画面比例,默认 1024
预计约 5~10 分钟 · 消耗余额/积分,结果 24 小时内有效请及时保存
对标视频一键复刻
选一个喜欢的画面,换成你的人物,再让它说出你的文案。无需切换功能页。
先上传场景图片或对标视频
已有喜欢的场景图片?上传后先预览、选择画面比例,再点“使用图片,下一步”。下一步上传要替换成的人物照片。
JPG / PNG / WebP,20MB 以内;支持竖屏、横屏、方图,可选择改图。
上传本地视频,或填写允许跨域读取的 HTTPS 视频直链。
平台分享页通常无法直接读取。可先保存视频后上传;视频直链须允许跨域读取。
选择你喜欢的一帧
上传图片直接换人;上传视频则在这里选择画面
保持原画面比例,不强制裁成竖屏
此处选择会带到下一步,换人前仍可修改。改变比例可能会重新构图。
优先选择人物清晰、正面或轻微侧脸、无遮挡的画面。逐帧按钮按视频平均帧率移动。
口播文案 · 提取后仿写(可选)
视频可提取口播;直接上传图片时,粘贴自己的文案即可。先预览,再决定是否用于后续声音克隆;不自动覆盖原文。
使用已配置的语音 API 提取口播,支持 10 分钟以内有声音的视频。音轨会发送到该服务,可能产生费用;请先配置语音 API,识别结果请校对。
配音文案最多 2000 字。超长不会自动截断,请分段或自行编辑。仿写不保证原创度或平台审核结果。
换人前,先调整一下画面?
可选 · 可以跳过可对选中的画面做二次创作,再用结果换人。只处理你有权使用的素材;改图不保证通过平台查重,也不保证每次保留全部细节。
未改图,直接使用原画面。
点击生成才会按所选功能扣体验次数 / 积分;跳过本步骤不会提交改图任务。
生成后对比预览
原画面 + 你要替换的人物
默认调用你指定的“图生图换人”,复用同一接口和积分规则。
已加入去除画面文字。多人画面可写“只替换中间穿白衣服的人,其他人不变”。去字与换人在同一次生成中完成,以实际结果为准;可自由增删要求。
选帧在本机完成。换人按现有图生图功能扣体验次数 / 积分,提交前会再次确认。
让这个人物说什么?
最多 2000 字,不自动删减内容;实际配音不能超过 1 分 40 秒。
声音样本上传后自动保存到音色库,下次直接选择。
情感参考
可选音色决定“是谁的声音”,情感参考决定“怎么说”。可上传你有权使用的语气音频,模仿情绪和说话方式;不选则使用音色自带语气。
支持 WAV、MP3、M4A、AAC、FLAC、OGG、OPUS、WEBM,100MB 以内。上传后自动保存到情感参考库,下次可直接选择。
未选择情感参考,使用音色自带语气。
这一步只合成配音。完成后可试听,再选择数字人功能;不选就不会提交视频。无需重复下载、上传。
已确认的人物画面
默认推荐:主播同款数字人
配音 ≤ 1 分钟最长边 1024 · 默认 84G 显存
1 分钟 ~ 1 分 40 秒最长边 1024 · 84G 显存
超过 1 分 40 秒保留配音,提示分段,不提交视频
以生成后实际配音时长为准。此流程复用选定画面的场景与构图生成新口播,不会完整复制原视频的动作、剪辑和背景音乐。
一键数字人,不用来回传素材
选好音色后,只需文案和一张人物照片。先合成语音,再自动制作慢速高清视频。
正面、清晰、单人照片;JPG / PNG / WebP,20MB 以内。仅使用你有权使用的人像与声音。
首次使用需要一份声音样本。之后可直接使用音色库,不用每次上传。
开始前检查素材与账户;体验版按每条流程独立计次,不扣声音克隆等其他额度。默认使用 84G,按实测时长校验;超过 100 秒保留语音并跳过视频。不要反复点击生成。
自动生成进度
- ① 自动合成语音
- ② 检测时长 · 自动选择显存
- ③ 自动接入数字人慢速高清
- ④ 预览与下载成片
开始后本批次沿用所选模式。新任务默认最高显存;原批次保留原配置,已提交任务不改变显存。
自动模式:60 秒整用 48G,超过 60 秒至 100 秒(含)用 84G;全 84G 模式在 100 秒以内均用 84G。超过 100 秒跳过视频并保留语音,继续处理下一条。显存更大不保证更快或成功,消耗可能更高。
超过 1 分 40 秒,已跳过视频生成
请保持软件打开。暂停或关闭不会取消已提交任务;再次打开可继续查询。语音和视频分别保存在“生成记录”中,消耗也在那里查看。
已合成语音 · 可先试听
下载语音数字人成片
下载视频多条文案,一次安排
上方选一次人物和音色,这里一次添加多条文案,自动配音、接入数字人慢速高清。
第一次使用?看这 6 条就会了
- 先选素材,再加文案。在上方选择人物照片、音色(体验版可用内置素材),点击“添加一条”粘贴文案,或一次导入多个 UTF-8 TXT,每个文件生成一条独立视频。每批最多 200 条,每条最多 2000 字,不会截断原文。
- 备用账户同时最多 3 个,钱包模式同时最多 50 个。完成一个自动补下一个,不必等整组完成。语音和视频共用任务名额,本机其他生成任务也占用名额;实际速度还受服务排队影响。自动模式按实际配置选择,不会默认按 50 个提交。
- 参数不用调。自动配音 → 检测真实时长 → 数字人慢速高清,最长边 1024;自动模式 ≤60 秒用 48G,>60 秒且 ≤100 秒用 84G;也可选全部 84G。无需再点“整段生成”;>100 秒自动跳过视频、保留语音并继续后面的文案。
- 超过 1 分 40 秒,必须分段。开始前把文案按完整句子拆成多条,约 1 分 40 秒可先拆成两段约 50 秒;每段约 150~180 字仅作参考,以实测时长为准。超长条目已自动跳过视频,处理完本批次后可新建分段批次。下载小视频后到剪辑软件按顺序拼接,本功能不自动拼接。
- 每条分别消耗,不是整批扣一次。每条语音与视频分别产生生成消耗;并发不是免费次数。失败只重试失败步骤,视频失败保留已生成语音;重试仍会产生新的消耗。体验版与手动功能共用原次数,用完或到期停止新任务。
- 请保持软件和本页面打开,电脑不要休眠。暂停或关闭不会取消已提交任务,也不代表停止计费;重新打开点击“继续批次”核对并接着做。批次固定创建时的账户,切换账号会暂停。状态不明的任务不会自动重提,请先核对生成记录。列表显示真实阶段、耗时,仅在服务提供时显示百分比。
打包仅包含当前批次已完成的成品,不附带文案、人物图或情感参考。可边生成边下载;未完成的视频不会混入,稍后可再打包。
等待说明:49 分钟不算超时;满 50 分钟仅提示等待较久,仍继续查询。网络中断自动重连,不重复提交;仅后台明确失败或取消才标记未完成。请保持软件和页面打开。手动暂停或账号失效仍需处理。
新手教程:超过 1 分 40 秒,怎样分段生成?
- 先按完整句子拆文案。每段围绕一个意思,可先控制在约 150~180 字;这只是起步参考,语速不同,最终以合成语音的实测时长为准。不要把一句话截成两半。
- 返回编辑。点击“结束此流程 / 修改文案”,把完整文案先复制保存,再只留下第一段。原来生成的语音仍在“生成记录”里,不会删除。
- 同一张照片、同一个音色。点击“一键生成语音和数字人”。默认使用最长边 1024 + 84G。建议每段 30~60 秒;60~100 秒运行风险更高,超过 100 秒请继续缩短。
- 逐段完成并下载。第二段、第三段重复操作。建议按“01 开场、02 正文、03 结尾”保存视频,便于排序。
- 最后拼接。把所有小视频按顺序放入你使用的剪辑软件,检查衔接、音量和字幕后导出。这个快捷功能不会自动拼接多段视频。
示例:约 1 分 40 秒的内容,优先拆成两段约 50 秒。每次重写文案重新生成语音,会产生新的消耗;请先确定分段再开始。
王炸功能 主播同款数字人:更高画质的"虚拟主播"说话视频
点击选择或拖拽人物图到这里
慢速版质量更高,运行更久点击选择或拖拽音频到这里
建议 30 秒内,效果更佳默认最长边 1024,保持原图比例;超过 1024 模型可能报错
预计约 25~30 分钟 · ⚠️ 较慢
提示:默认 84G,建议每段 30~60 秒。100 秒口播按用户反馈可能运行 50 多分钟,接近平台运行窗口;显存不足时缩短音频或降低最长边。
图片创作
描述画面,或上传参考图进行编辑。
GPT2.5 使用企业级通道,按 Token 用量计费;实际费用以账户账单为准。参考图与结果链接约 24 小时有效,请及时下载。此版本不支持遮罩编辑。
创作结果
完成后可预览、下载视频电商爆款复刻
上传参考人物图与对标视频,将参考画面的动作迁移到新人物上。先看案例,再用短片段试跑。
效果案例 · 点击视频播放
上传清晰参考图
JPG、PNG、WebP · 25MB 以内上传动作清晰的对标视频
MP4、MOV、WebM · 200MB 以内 · 建议先做 5~10 秒填 0 使用整段视频。本软件单次限制 60 秒;这不是上游保证完成的时长。新手先用 5~10 秒,避免长视频运行超时。
先上传参考图和对标视频。
按当前所选积分 / 钱包模式计费,实际消耗保存在任务记录。生成效果会随人物姿态、遮挡和素材清晰度变化。
处理中可到“任务中心 / 记录”查看进度
Qwen Image 2.1 PE 图像编辑
上传图片,用一句话修改画面。支持换背景、修细节、改文字,也可结合多张参考图。
点击选择,或拖入多张图片
第 1 张为主图,其余为参考图 · 每张不超过 25MB本功能消耗积分,画质按模型建议固定为 2.2 百万像素。显存越高消耗可能越多;实际扣除积分以任务记录为准。
先上传主图,再填写修改要求。
任务和积分消耗同步显示在生成记录
- 保留什么:人物、商品或整体构图。
- 修改什么:背景、颜色、文字或细节。
- 参考哪张图:按左侧图片编号描述。
生成后及时下载,云端结果链接通常保留 24 小时。
哔哩哔哩封面
上传一张参考图,写下封面主题,自动生成可以下载的封面图片。
点击选择,或把图片拖到这里
人物照 / 产品图 / 视频截图 · JPG、PNG、WebP · 50MB 以内文字由模型绘制,下载前请检查标题是否完整、有没有错字。
选择一张人物照、产品图或视频截图。
每次生成单独计费。结果链接通常保留 24 小时,请完成后及时下载;这里生成的是图片,不受视频默认宽高限制。
任务进度同时保存在生成记录
- 主标题尽量简短,先突出一个重点。
- 参考图主体清晰,给文字留一点空间。
- 先用 2K 确认设计,再按需要选择更高画质。
封面即点击率 封面设计:上传照片,AI 一键出爆款封面
点击选择或拖拽视频帧 / 图片到这里
从视频里截一帧做参考,效果更贴合点击选择或拖拽图片到这里
可选补充参考点击选择或拖拽图片到这里
可选补充参考点击选择或拖拽图片到这里
可选补充参考上传参考图约 ¥0.07/张;纯AI生成约 ¥0.29/张(seedream 文生图)。按钱包余额扣费,生成后自动保存到记录
提示:结果图片 24 小时内有效,请及时下载。
防查重 洗图:一键重绘,像原图又查重不过 · 商家必备
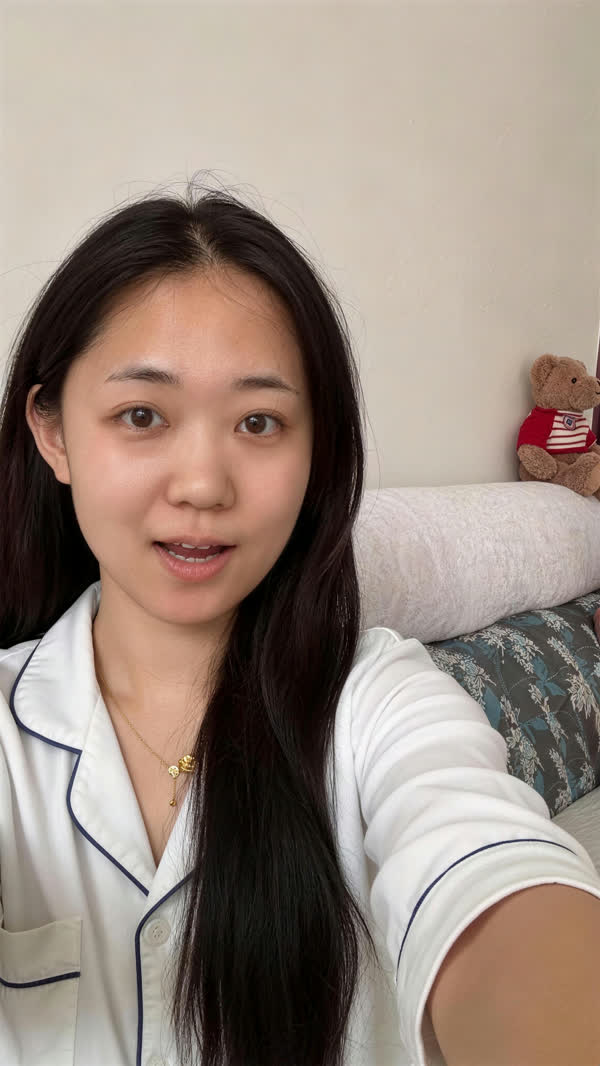 洗图前
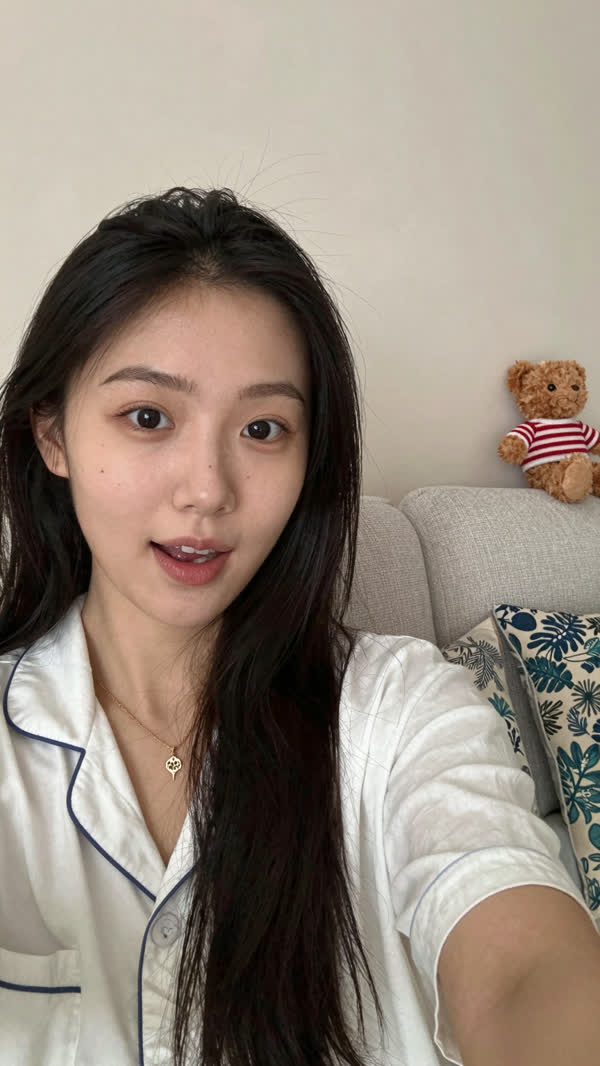 洗图后
点击选择或拖拽图片到这里
自动读取尺寸并设置长边预计 2~3 分钟
提示:结果会自动做「洗图前 / 洗图后」对比展示;生成后也会自动保存到「生成记录」并缓存到本地。
成交页面 详情页设计:上传产品图,AI 写出"让人下单"的卖点文案
上传一张产品图(比如锅、衣服、零食),AI 会自动分析产品,帮你写出卖点话术、直播脚本、详情页文案——按你选的价格带、活动、屏数输出。适合做电商带货、发商品详情、写直播话术,不用自己憋文案了。
点击选择或拖拽产品图到这里
产品清晰白底图效果最好大白话:AI 看了产品图,帮你把卖点、话术、详情页文案全写好,直接复制就能用。消耗账户余量(生成方案类)。
让照片动起来 动作迁移:让照片里的人,做出视频里一模一样的动作
点击选择或拖拽图片到这里
要"动起来"的那个人点击选择或拖拽视频到这里
人物图里的人会做出这个视频里的动作秒数×帧率=加载帧数(建议 ≤35 秒)
大白话:上传一个人物的照片 + 一段参考视频,AI 让照片里的人做出参考视频里的动作(说话、手势、跳舞等)。「动作迁移」保留动作换成新人物;「人物替换」是把参考视频里的人直接换成照片里的人。
视频对口型 · 高级版
上传已有的人物视频和新的配音,让画面中的人物跟着音频说话。
点击上传,或拖入人物视频
MP4、MOV、WebM · 120MB 以内点击上传,或拖入新的配音
MP3、WAV、M4A、AAC、FLAC、OGG · 50MB 以内建议先用 10~30 秒、人物嘴部清晰的素材。视频与配音尽量保持相近时长。长片建议分段,实际完成时间受素材和平台负载影响。
先上传人物视频和配音音频。
按顶部所选“消耗积分 / 消耗钱包 / 按功能自动选择”运行,实际消耗在任务记录中查看。
进度和消耗同时保存在“任务中心 / 记录”
- 人物面部和嘴部清晰,尽量减少遮挡和大幅转头。
- 配音清楚,避免多人同时讲话或过强的背景音乐。
- 先用一段短素材确认效果,再制作较长的视频。
此模型直接使用上传的视频和音频,不提供独立的宽高、秒数或提示词设置。上游未公布可保证完成的最长时长。生成后请及时下载,结果链接通常保留 24 小时。
嘴型同步 视频对口型:给任何人配音,嘴型严丝合缝
上传一段人物说话的视频 + 一段音频(语音/配音),AI 会让视频里的人物嘴巴跟着音频动——就像 TA 真的在说这段音频的话一样!适合:给已有口播视频换配音、给视频配别的语言、把文案换成自己的声音。
点击选择或拖拽人物视频到这里
视频里的人物会跟着音频说话点击选择或拖拽音频到这里
可用「声音克隆」生成的语音,也可传任意音频大白话:视频里的人物原本没说话/说别的,AI 让 TA 的嘴巴按你上传的音频动起来。消耗账户余量(生成方案类)。
网红同款 模仿跳舞:一张照片,让人跳起网红舞
点击选择或拖拽人物图到这里
正面清晰人像效果最好点击选择或拖拽参考视频到这里
照片里的人会照着这个视频的动作动起来预计 5~15 分钟 · ⚠️ 较慢
大白话:上传一张照片 + 一段舞蹈视频,AI 让照片里的人照着视频跳起来,像 TA 在跳舞一样!适合给自己的形象做舞蹈视频、给角色加动作。消耗账户余量(生成方案类,⚡自动模式扣余额)。
清晰不糊 图片高清放大:像素级提清,放大也经得起看
点击选择或拖拽图片到这里
支持 jpg / png / webp 等,自动读取尺寸预计 1~3 分钟
提示:放大倍数越高耗时越久;结果自动做「原图 vs 放大后」对比,并保存到生成记录。
视频编辑
上传视频 → 选择处理方式 → 描述目标 → 查看并保存结果。先用 5 秒短片尝试效果。
当前是 AI 视频编辑:输入一段视频,再告诉 AI 你希望修改什么。
编辑设置
每次处理 1~10 秒只处理选中的片段,单次最多 10 秒;不是自动剪辑整条长视频。
视频预览
输入文件保留 · 结果独立保存云端结果链接仅保留 24 小时,完成后请及时保存;本地保存状态会在这里显示。
任务动态
尚未提交选择视频并写下要求,不会自动产生云端费用。
显示真实任务阶段,不用估算百分比冒充完成度。
最近编辑
已提交的任务会保留在“生成记录”中。
视频换背景 · 效果案例
三个独立效果案例,画面完整显示;可点击“放大观看”查看细节。
案例仅作效果展示,不是你的输入素材,不会自动参与生成。
视频高清放大:上传视频,AI 一键提升清晰度
上传一段画质较糊 / 分辨率较低的视频,AI 会把它整体提清、去噪、补细节,输出一条更高清的成片,适合放大后在直播、短视频里再用。
点击选择或拖拽视频到这里
越长越耗时,建议先传 10~30 秒片段大白话:把一条视频喂给 AI,它会自动提清、去噪、放大,输出更高清的成片。消耗账户余量。
视频反推(上传爆款/热门视频 → AI 反推出可复用的脚本/提示词)
上传一段爆款 / 复刻 / 运动类 / 旧版风格的视频,AI 会逆向拆解它的内容与节奏,为你反推出可直接复用的视频脚本或提示词,帮助你快速复制热门思路。
点击选择或拖拽视频到这里
爆款 / 复刻 / 运动类 / 旧版 风格视频大白话:把一条爆款视频喂给 AI,它会吐出这条视频背后的脚本和提示词,省去你自己拆解、写文案的时间。消耗账户余量。
全能参考视频:参考图 + 提示词 → AI 生成新视频
把已有的参考图(风格 / 人物 / 场景)交给 AI,再填一段画面描述与参数,它会融合这些素材的风格与内容,生成一条全新视频。
提示:该功能目前仅支持 default(24G) / plus(48G),暂未开放 84G。选 84G 会报错。
大白话:把「参考图 + 提示词 + 参数」一起交给 AI,它会融合这些素材的风格与内容,生成一条符合描述的新视频。消耗账户余量。
高级全能参考:多图 + 多音频 + 视频 + 提示词 → AI 生成视频
把参考图(风格 / 人物 / 场景)、参考音频(配音 / 音效)与参考视频(动作 / 运镜)一起交给 AI,再填一段画面描述,它会融合这些素材生成一条全新视频。
 案例 7 · 原图(图生视频)
大白话:把「参考图 + 参考音频 + 参考视频 + 提示词 + 参数」一起交给 AI,它会融合这些素材的风格与内容,生成一条符合描述的新视频。消耗账户余量。
高质量全能参考 · 7 图
上传 1~7 张参考图,描述人物、场景、产品和镜头动作,生成 6~30 秒的视频。支持 480p / 720p、单条生成和批量生成。
默认使用 24G;按需要选择显存档位。
消耗钱包 · 时长须为 6~30 秒的整数;完成后请及时下载保存。
高质量全能参考 · 4 图
上传 1~4 张参考图,描述人物、场景、产品和镜头动作,生成 6~30 秒的视频。支持 480p / 720p、单条生成和批量生成。
默认使用 24G;按需要选择显存档位。
消耗钱包 · 时长须为 6~30 秒的整数;完成后请及时下载保存。
短剧全能参考
人物、场景、声音一起参考,把一段故事变成视频。
- 01 添加参考素材 按需选择,不必填满
- 02 描述剧情 写清角色、动作与镜头
- 03 生成与下载 结果单独保存,不改素材
参考素材
可选 · 按选择顺序编号先写角色与场景,再写动作、对白和镜头。提示词中的素材编号,要与你上传的顺序对应。
高级设置 新手保留默认即可
生成会按账户规则消耗额度。长时长、多素材或更高画质通常需要更久;等待时无需重复提交。请仅上传你有权使用的素材。
生成结果
支持预览与下载文案仿写,一框就是一条
保留核心信息,换一种表达。换行只分段,不会把同一篇文章拆成多条。
正在读取本机模型配置…
补充要求与重点词(可不填)
第一次接 API?展开填写(管理员只需配置一次)
① 从模型服务商复制接口地址、API Key、模型 ID ② 按服务商文档选择接口格式 ③ 输入本软件管理员密码并保存。保存只校验填写,不调用模型、不消耗额度。
支持 OpenAI 兼容、Anthropic Messages、Gemini 原生格式;不是所有网站的 API 都通用。数字人生成密钥不能直接当文字模型密钥使用。
OpenAI 兼容:可填 https://服务商域名/v1 或完整 /chat/completions 地址;本机 Ollama 可填 http://127.0.0.1:11434/v1。
密钥仅保存于本机服务配置,不放入浏览器草稿、导出文件或任务记录。调用外部 API 时,原文和补充要求会发送给你选择的服务商,并可能计费。
支持 1~50 条;按顺序处理,不会一口气向接口并发提交。
草稿与结果保存在本机。关闭软件不会撤销已经发送的 API 请求;重新打开后仅查询原请求,不自动重做,也不自动继续下一条。
爆款拆解 视频文案提取:一键提取全网爆款口播文案
② 语音 API 配置(可选 · 和文字纠错接口分开)
本地识别不用配置。使用 API:向服务商确认支持 /audio/transcriptions 音频上传接口 → 填地址、Key 和语音模型 ID → 保存。普通 Chat Completions / AI 文字模型 文字聊天接口不能直接提取音频。
未读取配置;不会自动调用或测试付费接口。
只上传本条提取的音频,不上传视频画面。每条音频上限24MB;不自动拆分、重传或切换服务商。音频可能包含个人信息,请只上传获授权的素材。提取结果保留原文;可在每条结果中点击“校对错别字”,人工确认修改。
下载通常超过45秒,请按卡片显示的阶段等待,不要反复点击。关闭本页面后后台仍会处理;重新打开点击“继续查询”。完全退出软件会中断本地下载。链接失效、登录限制或解析服务不可用仍可能失败;可换公开链接或使用已有视频文件。本功能的2条下载队列与数字人3/50任务队列无关。
用法:① 粘贴链接(支持分享口令,会自动提取链接)→ ② 点「下载视频」→ ③ 预览视频并点「提取文案」。生成后自动保存到「生成记录」,刷新不丢。
一键成片 AI 智能剪辑:本地处理不花钱,口播一键成片
点击选择或拖拽视频到这里
mp4 / mov / webm,建议口播视频短视频几十秒出片,长视频稍等几分钟;生成后可下载。
一键成片(本地素材 + AI 脚本 → 自动配音 / 字幕 / BGM 合成短视频)
先在「我的素材库 → 成片素材」里分好组,这里选一个组点「套用」,该组素材会自动填到下方。
点击选择或拖拽多个视频/图片到这里
mp4 / mov / jpg / png 等,素材会按脚本自动拼接可从 BGM 库直接选,也可把本地音乐上传到库里,下次不用重复传。
高级设置(转场 / 字幕样式 / 文案策略)
素材越多、条数越多越慢;生成后可在线预览并下载。
系统会为每个主题自动写脚本、配音、加字幕,一条一条出片;素材用上方「套用该组」选好的那一组。
未选择(成片完成后可一键保存到指定文件夹)
对话剪辑 最强自动剪辑:一句话直接出成片
点击选择或拖拽视频到这里
mp4 / mov / webm,建议口播视频建议指令说清楚比例、倍速、是否要字幕/BGM;不填则默认去停顿 + 加字幕 + 跟随原比例。
生成记录
每次生成自动保存云端记录;远程结果链接可能过期,请及时下载。删除记录会同时移除消耗统计,请先导出明细。
积分消耗记录
显示当前账号的云端生成记录和实际消耗。任务结束后同步积分;未提供的消耗不代表免费。
默认仅打包成品视频;切换分类或打包内容会清空旧选择,避免混入其他记录。
设置
设置已锁定
此区域仅管理员可进入,请输入管理密码
手机 App 请先填电脑 IP 并保存,再输入密码解锁
标准模型(即梦5.0 / GPT-Image-2 / flash-lite / MiniMax 声音克隆)必须用「企业级-共享」Key。请联系管理员完成对应服务配置。
用备用 Key 调「声音克隆 / 数字人 / 洗图」生成方案时优先消耗账户余量;即梦 / GPT 等标准模型不支持,会自动用企业级-共享 Key。
此处用于其他文字功能,不会修改最强剪辑的独立模型配置。
登录 剪辑工作区 后,最强剪辑会用 AI 文字模型 调用 剪辑工作区 的剪辑工具,右侧可实时预览编辑器。
仅手机 App / 远程访问需要填。手机与电脑连同一个 WiFi 时,在电脑上查 IP 填入这里,保存后自动刷新。
填 API Key 后手机直接调云端,不用电脑 IP。支持全部生成功能(文生图 / 数字人 / 洗图 / 声音克隆等)。
卸载后不可恢复,请确认已保存需要的生成结果。
一键分发 发布神器:把文案 / 图片 / 视频一键发到小红书、抖音、微博等平台
① 先在电脑安装 MultiPost 桌面客户端 并登录要发布的平台账号;② 打开客户端「设置 → 外部 API」,开启后复制 服务地址 和 访问令牌 填到下面;③ 选好内容、勾选账号,点「一键发布」。生成记录里的成片也能直接选来发。
访问令牌只存在你本机,不经过云端、不回传作者。填完点「保存并检测」,绿灯说明已连上 MultiPost。
连接 Codex
点一下「连接 Codex」,就会把本软件的 AI 能力接入你电脑上的 Codex 桌面端。之后你在 Codex 里直接说「用我的音色把这段文字配音」「生成一张产品图」「查最近的生成记录」等,Codex 就能调用本软件帮你完成。
连接成功后,重启 Codex(或新建一个 Codex 会话),直接输入指令即可。本软件需要保持打开状态,Codex 才能调用到软件里的功能。
小红书 / 抖音 / 快手封面
上传一张参考图,写下封面主题,自动生成可以下载的封面图片。
点击选择,或把图片拖到这里
人物照 / 产品图 / 视频截图 · JPG、PNG、WebP · 50MB 以内文字由模型绘制,下载前请检查标题是否完整、有没有错字。
选择一张人物照、产品图或视频截图。
每次生成单独计费。结果链接通常保留 24 小时,请完成后及时下载;这里生成的是图片,不受视频默认宽高限制。
任务进度同时保存在生成记录